SQLite로 여러 블로그 이력을 합칠 때 글 ID 충돌을 막는 방법
질문: 서로 다른 블로그의 글 ID가 같다면?
이번 실험은 여러 블로그의 글 이력을 SQLite 한곳에 저장할 때 어떤 키를 써야 하는지 확인하는 작업이다. 글 ID만 기본키로 쓰면 서로 다른 블로그의 글을 같은 행으로 처리할 수 있을까? 블로그 식별자와 글 ID를 묶으면 각각의 이력을 유지하면서 같은 자료를 다시 넣을 수 있을까?
이 질문을 확인하려고 Blogger, Tistory, WordPress를 나타내는 세 개의 synthetic data를 사용했다. 세 플랫폼의 실제 글 ID가 같다는 뜻은 아니다. 서로 다른 블로그에서 글 ID가 모두 ‘1’이라고 가정한 예제이며, 실제 플랫폼 데이터를 수집하거나 운영 사고를 재현한 실험도 아니다.
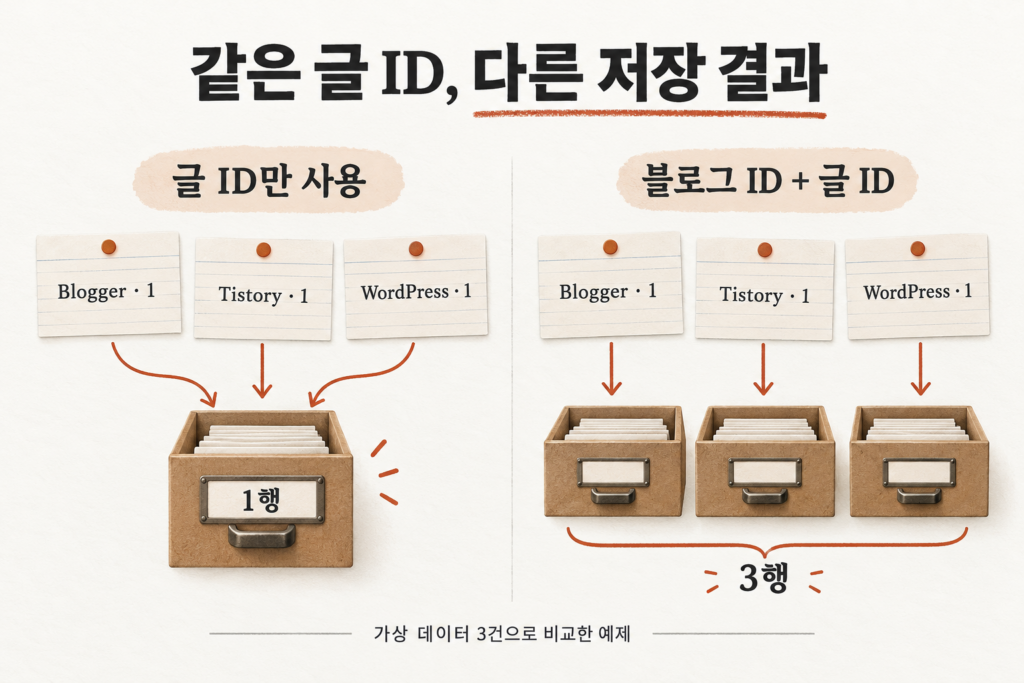
실험환경: 메모리 DB와 세 개의 가상 레코드
실제 측정일은 2026-10-09다. 실행 결과에 기록된 버전은 Python 3.14.5, SQLite 3.53.4다. Python의 sqlite3 모듈로 메모리 데이터베이스를 열고, 같은 입력을 두 가지 테이블에 저장했다. 파일 저장과 외부 서비스 연결은 실험에 포함하지 않았다.
single_id는 post_id 하나를 기본키로 삼는다. site_id는 blog_id와 post_id의 조합을 기본키로 삼는다. 블로그 식별자는 blogger:demo, tistory:demo, wordpress:demo로 구분했다. 두 테이블 모두 키 충돌 시 제목을 갱신하도록 UPSERT를 사용했다.
코드: 키만 바꿔 같은 입력 비교하기
아래는 실제 실행한 전체 코드다. 첫 입력 뒤 복합키 테이블의 행 수를 읽고, 동일한 fixture를 한 번 더 입력한 뒤 다시 비교한다. 마지막 assert는 단일키의 행 수가 1이고 복합키의 두 측정값이 모두 3인지 확인한다.
"""Synthetic data only: compare single-ID and site-scoped SQLite history keys."""
import json,sqlite3,sys
samples=[('blogger:demo','1','Blogger sample'),('tistory:demo','1','Tistory sample'),('wordpress:demo','1','WordPress sample')]
with sqlite3.connect(':memory:') as db:
    db.execute('CREATE TABLE single_id(post_id TEXT PRIMARY KEY, title TEXT)')
    db.execute('CREATE TABLE site_id(blog_id TEXT, post_id TEXT, title TEXT, PRIMARY KEY(blog_id,post_id))')
    for blog,post,title in samples:
        db.execute('INSERT INTO single_id VALUES(?,?) ON CONFLICT(post_id) DO UPDATE SET title=excluded.title',(post,title))
        db.execute('INSERT INTO site_id VALUES(?,?,?) ON CONFLICT(blog_id,post_id) DO UPDATE SET title=excluded.title',(blog,post,title))
    first=db.execute('SELECT COUNT(*) FROM site_id').fetchone()[0]
    db.executemany('INSERT INTO site_id VALUES(?,?,?) ON CONFLICT(blog_id,post_id) DO UPDATE SET title=excluded.title',samples)
    second=db.execute('SELECT COUNT(*) FROM site_id').fetchone()[0]
    result={'data':'synthetic','python':sys.version.split()[0],'sqlite':sqlite3.sqlite_version,'input_records':3,'single_id_rows':db.execute('SELECT COUNT(*) FROM single_id').fetchone()[0],'site_id_rows':first,'after_same_batch_again':second}
    assert result['single_id_rows']==1 and first==second==3
    print(json.dumps(result,ensure_ascii=False,indent=2))
실측결과: 단일키 1행, 복합키 3행
| 측정 항목 | 실측값 |
|---|---|
| 실제 측정일 | 2026-10-09 |
| 입력 자료 | synthetic data, 3 records |
| Python / SQLite | 3.14.5 / 3.53.4 |
| single_id: 글 ID 단일키 | 1행 |
| site_id: 블로그·글 ID 복합키 | 3행 |
| site_id: 같은 fixture 재실행 | 3행 |
단일키 테이블에서는 세 입력의 post_id가 같으므로 뒤의 입력이 기존 행의 제목을 갱신한다. 충돌 처리가 오류를 내지 않더라도 서로 다른 블로그의 이력을 구분해 보존하지 못하는 셈이다.
복합키 테이블에서는 글 ID가 같아도 blog_id가 다르므로 세 조합이 각각 저장됐다. 동일한 세 레코드를 다시 입력했을 때도 행 수는 3이었다. 이 실험에서 확인한 재수집 멱등성은 같은 fixture를 두 번 입력했을 때 행 수가 유지된 범위다. 다양한 수집 조건이나 전체 이력의 정확성까지 검증했다는 의미는 아니다.
한계: 키 설계 외의 운영 조건은 미검증
결과는 블로그별로 글 ID의 범위를 나누는 키 설계가 이 예제의 충돌을 막았다는 근거다. 실제 적용에서는 blog_id가 서로 다른 블로그를 안정적으로 구분해야 한다. 같은 플랫폼 안의 여러 블로그도 구별할 수 있어야 하며, 그 식별자를 정하는 방식 자체는 이번 코드에서 검증하지 않았다.
실제 DB에는 키 열의 NOT NULL 제약과 입력검증도 별도로 필요하다. 이 코드처럼 일반 rowid 테이블에 TEXT 복합 기본키를 선언하는 것만으로 NULL이 자동 금지되지는 않는다. 누락되거나 잘못된 식별자를 차단하는 처리를 더해야 이 예제의 전제를 실제 입력에서도 유지할 수 있다.
이번 실행은 세 레코드와 한 차례 재입력만 다뤘다. 성능, 동시쓰기, 네트워크 재시도, 삭제복구는 모두 미검증이다. 따라서 처리량이나 운영 안정성을 판단할 자료로 확대해서 읽을 수는 없다.
출처
- SQLite 공식 문서: CREATE TABLE — PRIMARY KEY는 단일 열 또는 여러 열의 조합으로 정의할 수 있다. 일반 rowid 테이블의 TEXT 복합 기본키는 NULL을 자동으로 금지하지 않으므로 별도 제약이 필요하다.
- SQLite 공식 문서: UPSERT — ON CONFLICT의 충돌 대상은 유일성 제약과 연결된다. DO UPDATE는 해당 충돌이 발생했을 때 기존 행을 갱신한다. 이 코드에서는 각 테이블의 기본키를 충돌 대상으로 지정했다.
실측값의 근거는 위에 실은 실행 코드와 출력 결과다. 공식 문서는 키와 UPSERT 동작을 설명하는 근거이며, 세 레코드 비교의 측정 결과와는 구분된다.
질문과 정정